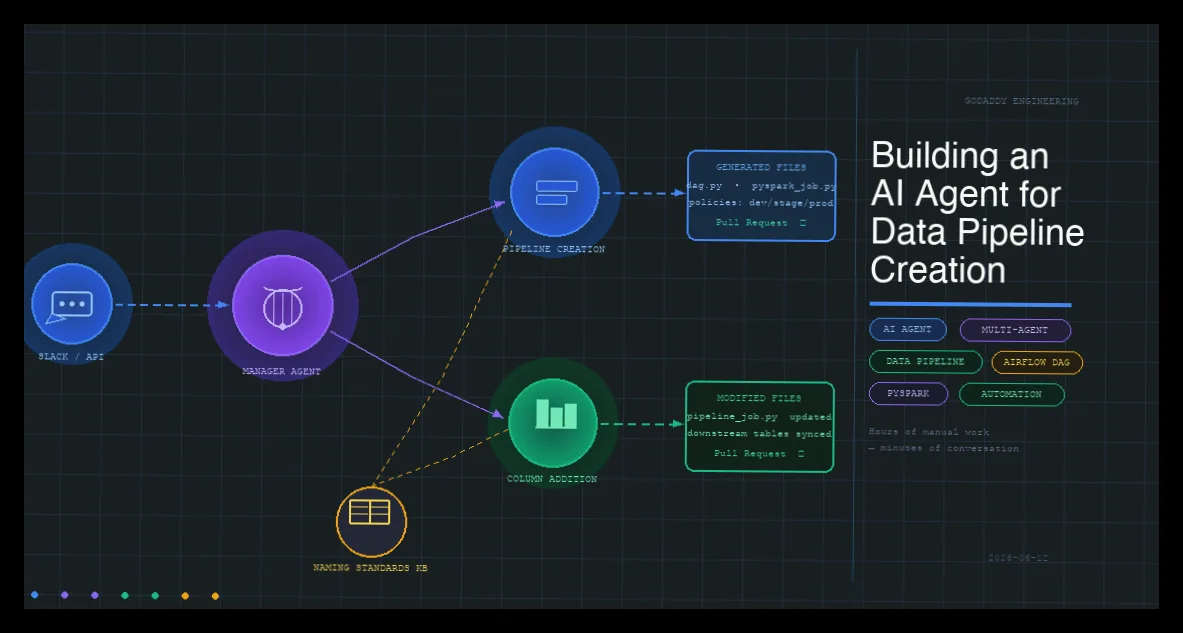
تیم ما در زمینه داده، برای تسهیل فرآیند اضافه کردن منابع جدید به دریاچه داده، عامل هوش مصنوعی به نام Pipeline Build Agent را طراحی کرده است. این عامل قادر است با یک پیام در Slack، تمام مراحل ساخت پایپلاینهای PySpark و Airflow DAG را بهصورت خودکار انجام دهد و زمان مورد نیاز برای این کار را از چند ساعت به چند دقیقه کاهش دهد.
در گذشته، هر بار که یک تیم محصول نیاز به لاگهای جدید از یک S3 باکت در دریاچه داده داشت، یک مهندس باید بهصورت دستی مراحل مختلفی را طی میکرد. این مراحل شامل باز کردن الگوها، استنباط ساختار داده، جستجوی کنوانسیونهای نامگذاری، پر کردن مسیرها و نامهای جدول، تولید فایلها و باز کردن درخواست ادغام (PR) بود. این کار زمانبر و مستعد خطا بود، در حالی که تمام اطلاعات و ابزارهای لازم برای انجام خودکار این فرآیند وجود داشت.
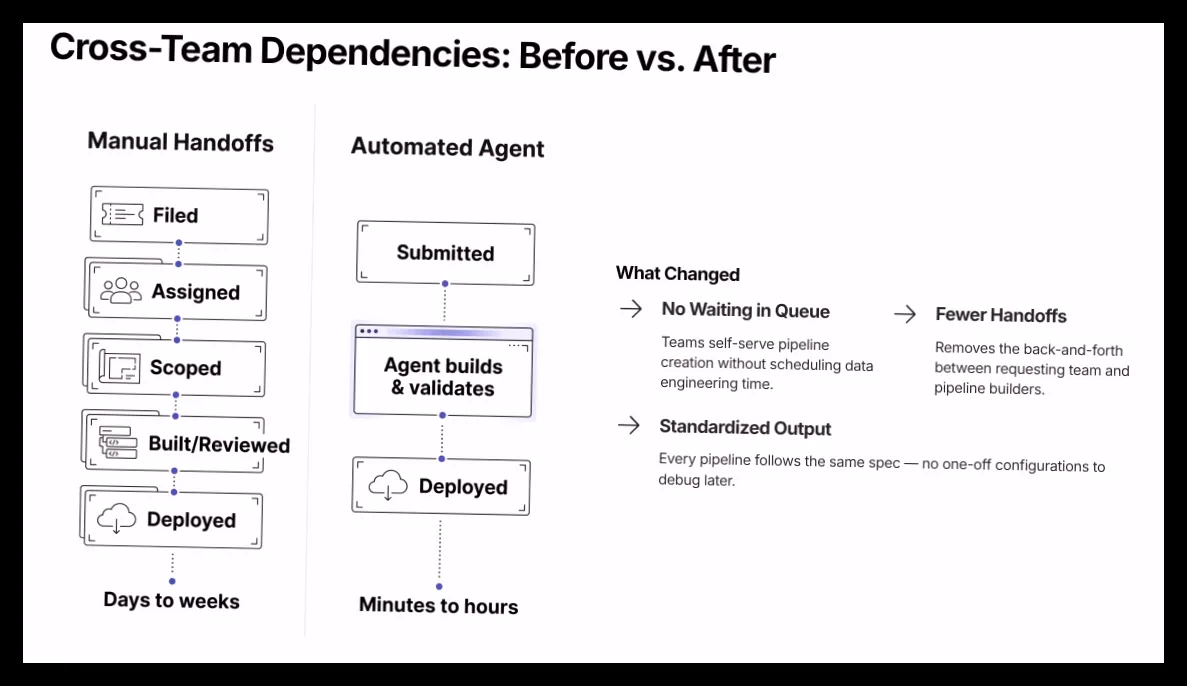
ما تصمیم گرفتیم بهجای نوشتن یک اسکریپت یا ابزار خط فرمان، یک عامل هوش مصنوعی بسازیم که بتواند با مهندسان گفتوگو کند. این عامل میتواند سوالات روشنی بپرسد، ساختار داده را بهطور خودکار از S3 استنباط کند و کل فرآیند را از ابتدا تا انتها مدیریت کند. این عامل در Slack مستقر شده و به مهندسان اجازه میدهد تا بهراحتی با آن ارتباط برقرار کنند.
عملکرد این عامل بهگونهای است که از یک معماری چندعاملی استفاده میکند. یک عامل مدیریت، قصد کاربر را شناسایی کرده و آن را به یکی از دو عامل متخصص ارجاع میدهد: عامل ایجاد پایپلاین و عامل افزودن ستون. عامل ایجاد پایپلاین مسئول بررسی ساختار S3، تولید فایلهای مورد نیاز و باز کردن PR است، در حالی که عامل افزودن ستون تغییرات را در پایپلاینهای موجود اعمال میکند.
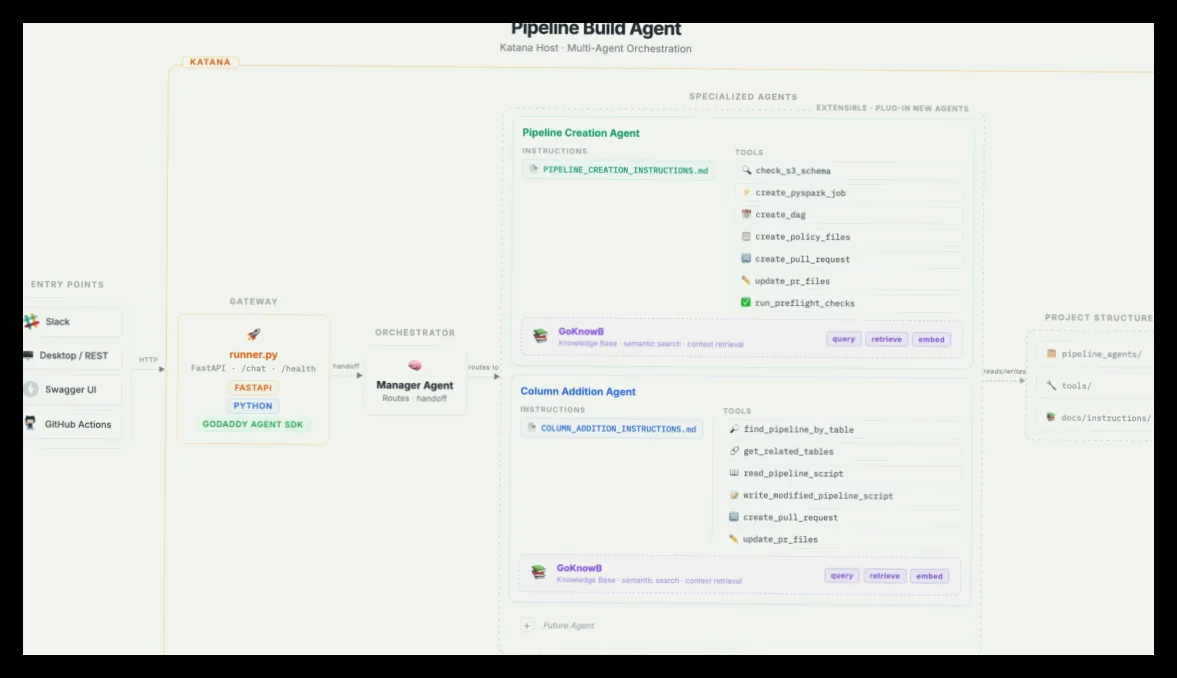
ما با استفاده از یک پایگاه داده دانش داخلی، اطمینان حاصل کردیم که نامگذاریها مطابق با استانداردهای ما باشد. این فرآیند به ما کمک کرد تا از تولید کدهای نادرست جلوگیری کنیم و از همان ابتدا نامها و مسیرها را مطابق با استانداردها تولید کنیم.
نتایج این پروژه بسیار مثبت بوده است. با استقرار این عامل، تیم ما توانسته است درخواستهای روزمره پایپلاین را از طریق Slack مدیریت کند و زمان لازم برای انجام این کار بهطور چشمگیری کاهش یافته است. ما همچنین به دنبال افزودن قابلیتهای جدیدی مانند خروجی به Redshift و S3 CSV و اعتبارسنجی پیش از PR برای DAGها و کدهای PySpark هستیم.
دیدگاه و پرسش